Anthropicが2026年4月16日、最新AIモデルClaude Opus 4.7をリリースした。前モデルOpus 4.6からわずか2ヶ月でのアップデートとなる今回は、エージェントコーディング性能の大幅向上、ビジョン解像度の3倍超強化、新エフォートレベル「xhigh」の追加など、開発者・ビジネスユーザー双方に関わる重要な進化が詰まっている。本記事ではベンチマークデータ・新機能・価格・競合比較を日本語で詳しく解説する。
目次
基本情報・価格・利用方法
| 項目 | 詳細 |
|---|---|
| リリース日 | 2026年4月16日 |
| モデルID | claude-opus-4-7 |
| コンテキストウィンドウ | 100万トークン |
| 入力トークン価格 | $5 / 100万トークン(Opus 4.6と同額) |
| 出力トークン価格 | $25 / 100万トークン(Opus 4.6と同額) |
| コスト最適化 | プロンプトキャッシュで最大90%削減 / バッチ処理で50%削減 |
| 利用可能プラン | Claude Pro / Max / Team / Enterprise |
| API・クラウド | Claude API / Amazon Bedrock / Google Cloud Vertex AI / Microsoft Foundry |
価格はOpus 4.6と据え置きのため、既存ユーザーは追加コストなしでアップグレードできる。ただし新しいトークナイザーの導入により、同じ入力テキストに対するトークン数が1.0~1.35倍に変動する場合がある点には注意が必要だ。
ベンチマーク徹底比較
Opus 4.7は、コーディング・推論・マルチモーダルの主要ベンチマークでOpus 4.6を上回った。以下はAnthropicが公開した公式比較表だ。
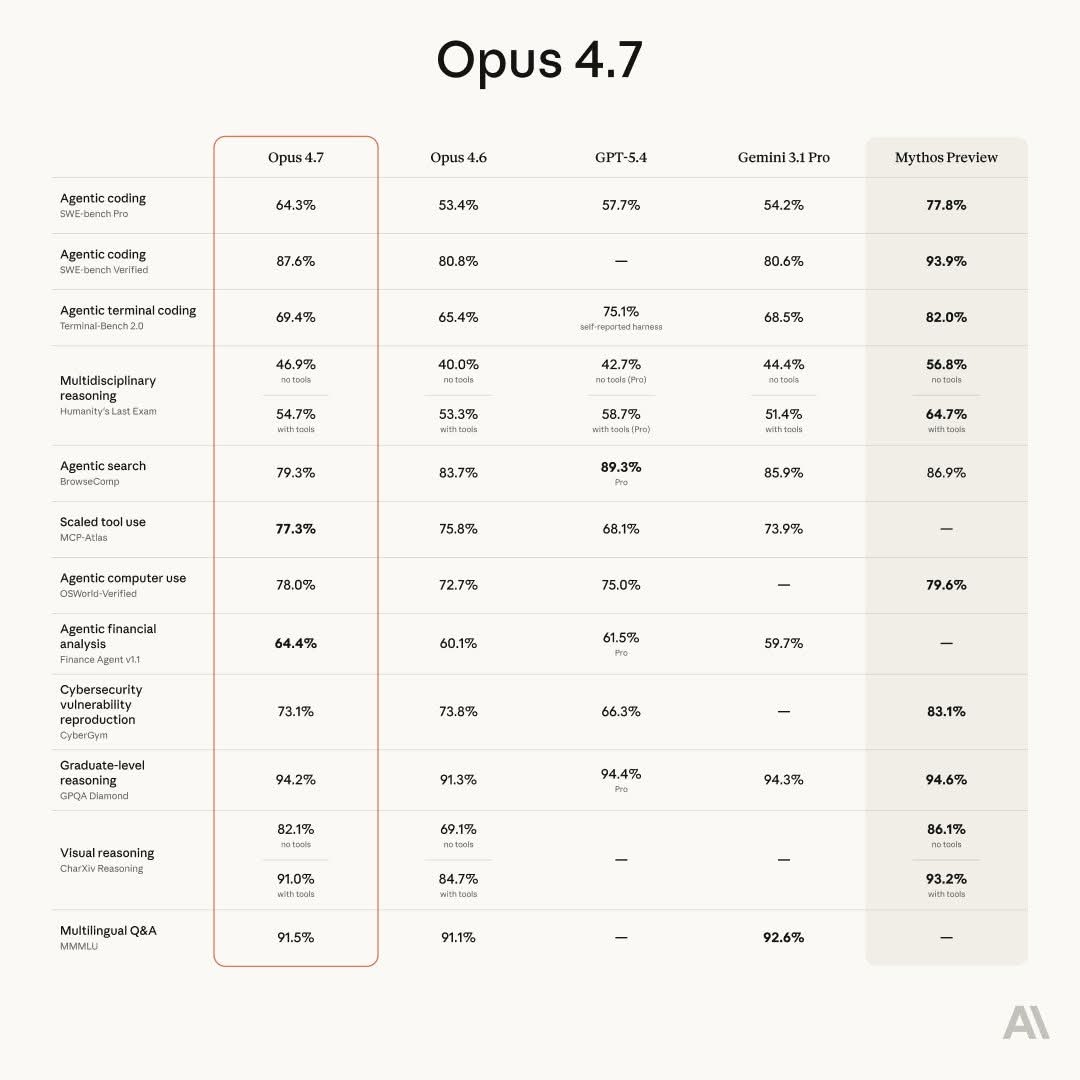
Anthropic公式ベンチマーク比較(Opus 4.7 vs Opus 4.6 vs GPT-5.4 vs Gemini 3.1 Pro vs Mythos Preview)
コーディング性能
| ベンチマーク | Opus 4.7 | Opus 4.6 | 差分 |
|---|---|---|---|
| SWE-bench Verified | 87.6% | 80.8% | +6.8pt |
| SWE-bench Pro | 64.3% | 53.4% | +10.9pt |
| CursorBench | 70% | 58% | +12pt |
| Terminal-Bench 2.0 | 69.4% | 65.4% | +4.0pt |
特にSWE-bench Proでの+10.9ptの伸びは目を引く。これは実際のGitHubリポジトリにおける高難度バグ修正タスクであり、Opus 4.6やSonnet 4.6では解けなかった問題をOpus 4.7が解決できたケースが報告されている。CursorBenchでも12ptの大幅向上を記録しており、IDE連携でのコード生成品質が着実に進化している。
推論・マルチモーダル・エージェント性能
| ベンチマーク | Opus 4.7 | Opus 4.6 |
|---|---|---|
| GPQA Diamond(大学院レベル推論) | 94.2% | 91.3% |
| Humanity’s Last Exam | 46.9% | 40.0% |
| CharXiv 視覚推論(ツールなし) | 82.1% | 69.1% |
| OSWorld コンピュータ操作 | 78.0% | 72.7% |
| MCP Atlas(ツール利用) | 77.3% | 75.8% |
| FinanceAgent v1.1 | 64.4% | 60.1% |
| MMLU(多言語QA) | 91.5% | 91.1% |
CharXiv(視覚推論)での+13ptの向上が特に印象的だ。化学構造式や技術図面の読み取り精度が大幅に改善されており、ドキュメント推論においてもOpus 4.6比で21%のエラー削減を達成している。
エフォートレベル別性能
Opus 4.7では、従来のlow / medium / high / maxに加えて、新たに「xhigh」(extra high)レベルが追加された。highとmaxの間に位置する新設定で、推論の深さとレイテンシのバランスを細かく制御できるようになった。
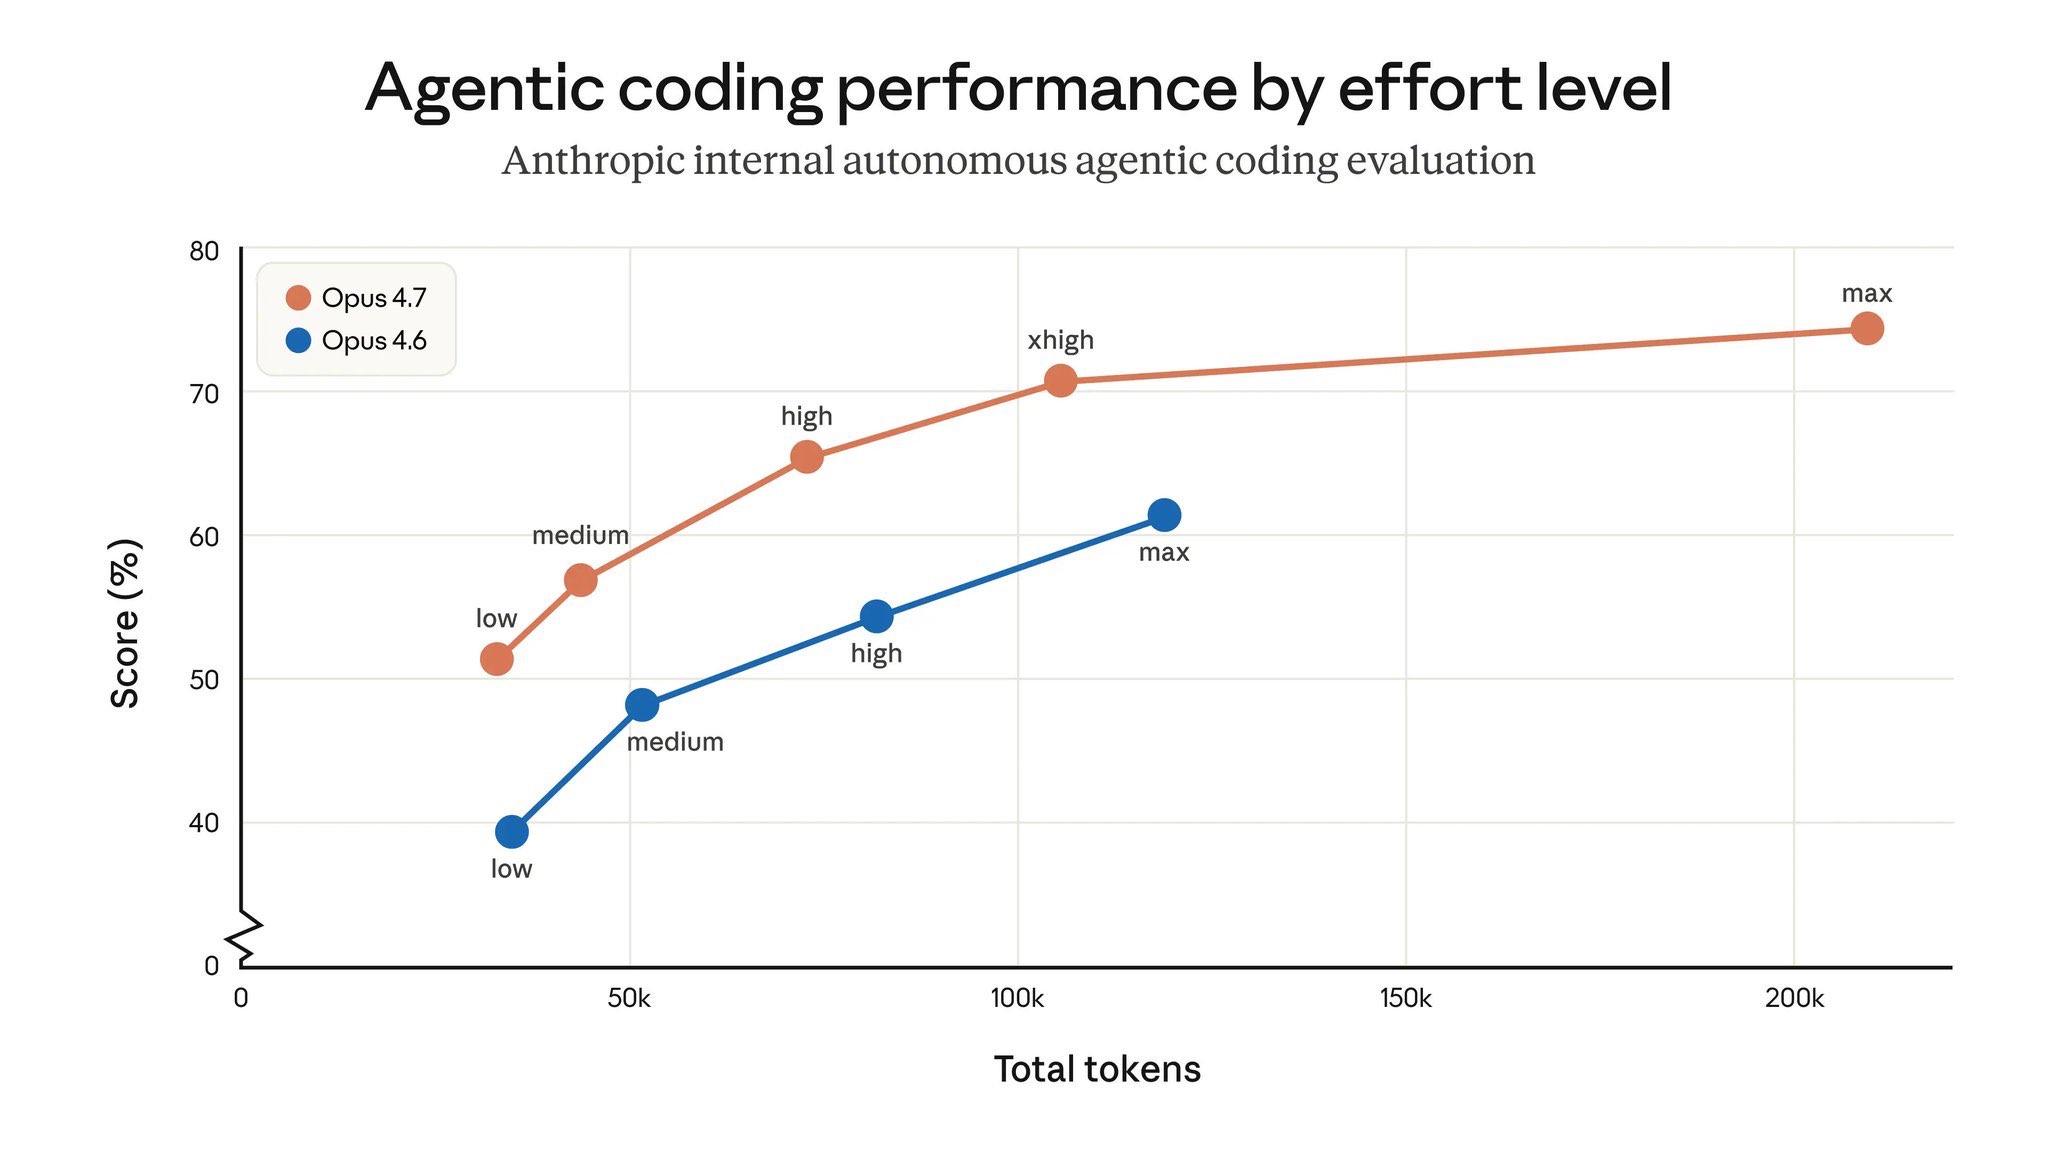
Anthropic社内評価: エージェントコーディング性能のエフォートレベル別比較
グラフの読み方
- Opus 4.7は全エフォートレベルでOpus 4.6を上回っている
- low effortのOpus 4.7(約51%) は medium effortのOpus 4.6(約48%)と同等以上
- xhigh(約100kトークン)で71%を達成。Opus 4.6のmax(200kトークン)の61%を大幅に上回る
- つまり半分のトークン消費でより高い性能が出せる
Claude Codeでは全プランのデフォルトエフォートレベルがxhighに引き上げられた。開発者は従来のmax設定よりも少ないトークン消費で、同等以上の結果を得られるようになった。


ビジョン性能の飛躍
Opus 4.7はClaudeシリーズ初の「高解像度画像対応」モデルだ。処理可能な画像解像度がOpus 4.6の約3倍以上に向上した。
| 項目 | Opus 4.7 | Opus 4.6 |
|---|---|---|
| 最大解像度(長辺) | 2,576px(約3.75MP) | 1,568px(約1.15MP) |
| 視覚精度ベンチマーク | 98.5% | 54.5% |
| 視覚ナビゲーション(ツールなし) | 79.5% | 57.7% |
スクリーンショット、密度の高い技術図面、デザインモックアップ、ドキュメントを本来の解像度で処理できるようになった。化学構造式の読み取りや複雑なダイアグラムの解釈精度も大幅に向上しており、研究者やエンジニアにとって実用的な改善だ。
主要な新機能
1. 指示追従性の大幅向上
Opus 4.7はユーザーの指示をより文字通りに解釈し、忠実に実行するよう改善された。複雑なマルチステップのワークフローでも、途中で指示から逸脱しにくくなっている。ただしその分、Opus 4.6で動いていたプロンプトの微調整が必要になるケースもある。
2. ファイルベースメモリの改善
マルチセッションにまたがる作業で、ファイルシステムをスクラッチパッドとして活用する際の信頼性が向上した。長期的なプロジェクト管理やエージェント的な自律作業に有利だ。
3. Claude Code向け新機能
- /ultrareview — 専用のマルチエージェントコードレビューセッションを起動し、バグや設計上の問題を検出する新コマンド。Pro/Maxユーザーに3回分の無料利用枠が付与される
- タスクバジェット(パブリックベータ) — 長時間の自律実行におけるトークン消費量をガイドする新機能
- 拡張オートモード — Maxユーザー向けに、Claudeが自律的に判断して作業を進めるモードが拡張された
4. 適応型思考(Adaptive Thinking)
タスクの複雑さに応じて推論の深さを自動調整する機能。簡単な質問には素早く回答し、難しい問題にはより多くの思考トークンを割り当てる。
長文コンテキストの注意点
100万トークンのコンテキストウィンドウは維持されているが、長文コンテキスト内の情報検索能力(MRCR)ではOpus 4.6が優位という結果が出ている。
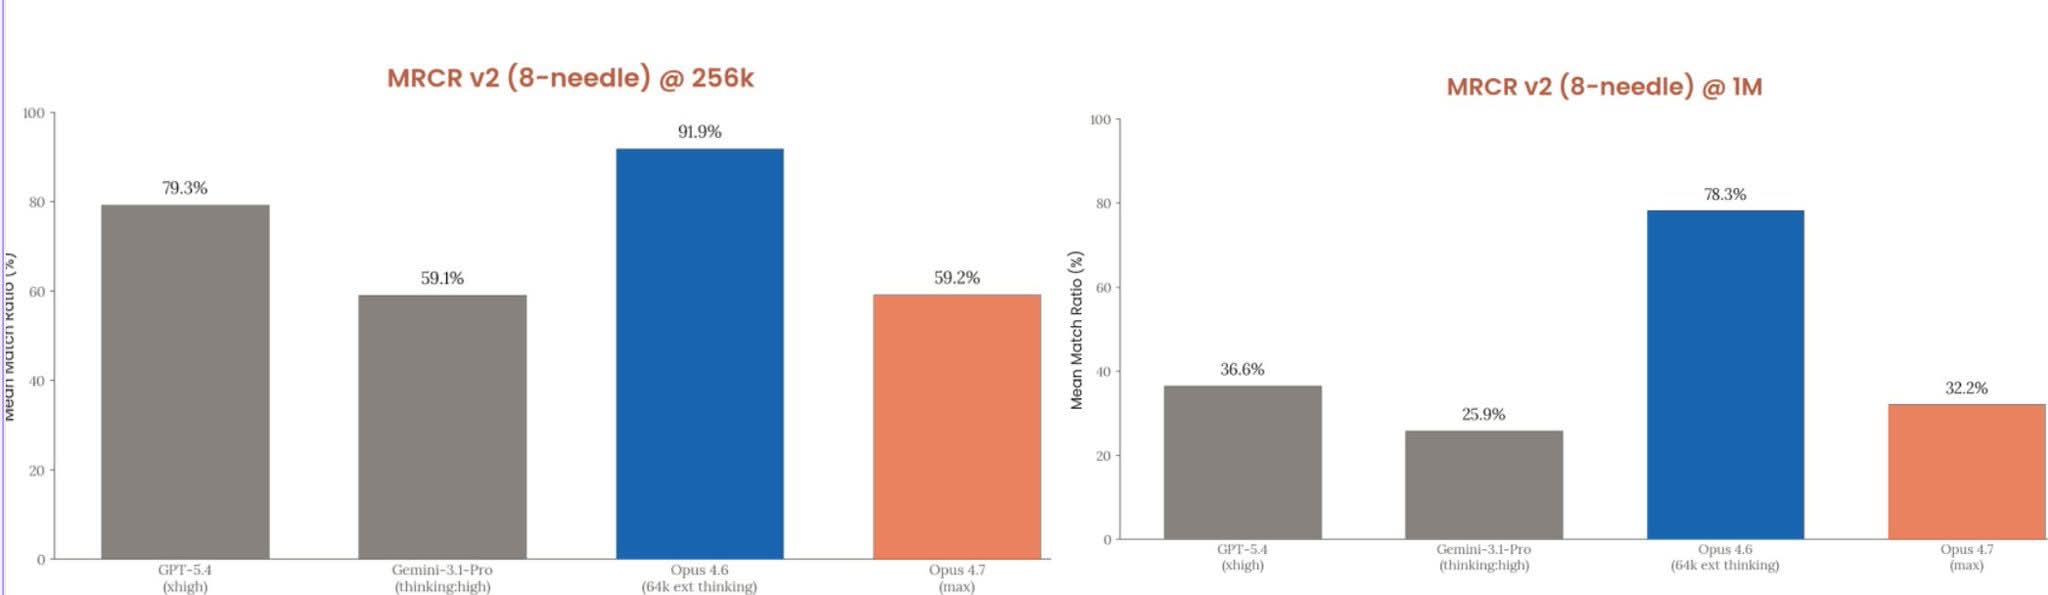
MRCR v2(8-needle): 256kトークンおよび100万トークンでの情報検索精度
MRCR v2スコア比較
- 256kトークン: Opus 4.6が91.9%で圧倒 / Opus 4.7は59.2%
- 100万トークン: Opus 4.6が78.3% / Opus 4.7は32.2%
- GPT-5.4は256kで79.3%、100万で36.6%
大量のドキュメントからピンポイントで情報を抜き出すようなユースケースでは、Opus 4.6の方が向いている場合がある。一方でOpus 4.7はコーディングや推論タスクでの総合力が上がっているため、用途に応じた使い分けが重要だ。
競合モデルとの比較
Opus 4.7はOpenAIのGPT-5.4、GoogleのGemini 3.1 Pro、そしてAnthropic自身の非公開モデルMythos Previewと比較されている。
| ベンチマーク | Opus 4.7 | GPT-5.4 | Gemini 3.1 Pro | Mythos Preview |
|---|---|---|---|---|
| SWE-bench Pro | 64.3% | 57.7% | 54.2% | 77.8% |
| GPQA Diamond | 94.2% | 94.4% | 94.3% | 94.6% |
| OSWorld | 78.0% | 75.0% | — | 79.6% |
| BrowseComp | 79.3% | 89.3% | 85.9% | 86.9% |
Opus 4.7はコーディングとエージェント操作においてGPT-5.4・Gemini 3.1 Proを上回るが、BrowseComp(Web検索エージェント)ではGPT-5.4に及ばない。Mythos Previewは多くのベンチマークでOpus 4.7を上回るものの、現時点では一般公開されておらず、AWS・Apple・Google・Microsoft等の「Project Glasswing」パートナー企業にのみ提供されている。Mythos Previewは防御的サイバーセキュリティ用途に限定されており、一般ユーザーが利用できるのはOpus 4.7が最上位モデルとなる。
安全性・サイバーセキュリティ対策
- 安全プロファイル — Opus 4.6と同等の低い問題行動率を維持。欺瞞・追従・悪用協力のリスクが低い
- 正直さの向上 — プロンプトインジェクション攻撃への耐性がOpus 4.6から改善
- サイバーセキュリティ自動検知 — 禁止されたサイバーセキュリティ用途のリクエストを自動で検知・ブロックする機能を初搭載。Claudeモデルとしては初の試み
- Cyber Verification Program — 正当なセキュリティ専門家(脆弱性調査、ペネトレーションテスト、レッドチーム)向けの認証プログラムを新設
Anthropicはトレーニング段階でサイバー能力を意図的に抑制する実験も行っており、安全性と実用性のバランスを慎重にとっている。
実ユーザーの評価
早期テスターからの具体的なフィードバックが公開されている。
- 「low effortのOpus 4.7は、medium effortのOpus 4.6とほぼ同等」 — Hex共同創業者 Caitlin Colgrove氏
- 「93タスクのコーディングベンチマークで13%の解決率向上」
- 「Rakuten-SWE-Benchで3倍のプロダクションタスクを解決」
- 「マルチステップのワークフローで10~15%の成功率向上、エラーも減少」
- 「計画段階で自分自身の論理的な欠陥を検出し、自己修正する」 — VP of Technology Clarence Huang氏
- 「完全なRust製テキスト読み上げエンジンをゼロから構築し、出力を自己検証した」 — CEO Sean Ward氏
Opus 4.6からの移行時の注意点
- プロンプトの調整が必要な場合がある — 指示追従性が厳密になったため、Opus 4.6で曖昧に書いていた指示が意図通りに解釈されない可能性
- トークン数の変動 — 新トークナイザーにより、同じ入力でも1.0~1.35倍のトークン数になるケースがある。本番適用前にトークン消費量をテストすること
- BrowseComp性能の低下 — Web検索エージェントのベンチマークではOpus 4.6の83.7%に対して79.3%に低下している
- MRCR(長文情報検索)の低下 — 大量文書からのピンポイント検索が重要なユースケースでは、Opus 4.6の方が適している可能性がある
まとめ
Claude Opus 4.7 ポイントまとめ
- ▶SWE-bench Verified 87.6%、SWE-bench Pro 64.3%でコーディング性能が大幅向上
- ▶ビジョン解像度が3倍超(2,576px / 3.75MP)に強化
- ▶新エフォートレベル「xhigh」で半分のトークンでOpus 4.6のmaxを超える性能
- ▶価格はOpus 4.6と同額(入力$5 / 出力$25 per 100万トークン)
- ▶GPT-5.4・Gemini 3.1 Proを多くのベンチマークで上回り、一般公開モデルとして最高峰
- ▶サイバーセキュリティ自動検知・ブロック機能を初搭載
- ▶長文コンテキスト検索(MRCR)とBrowseCompではOpus 4.6が優位な場面も
Opus 4.7はコーディング・エージェント操作・ビジョンにおいて確実な進化を遂げたモデルだ。特に開発者にとっては、xhighエフォートレベルの導入により「少ないコストで高い成果」を出しやすくなった点が魅力的だろう。一方で長文コンテキストからの情報検索やWeb検索エージェント用途ではOpus 4.6が有利な場面があるため、タスクの性質に応じた使い分けが推奨される。
※本記事の情報は2026年4月16日時点のものです。ベンチマークスコア・価格・機能は変更される可能性があります。最新情報はAnthropic公式サイトでご確認ください。ベンチマーク画像はAnthropic社の公式発表資料より引用しています。
コメントを残す